NTT、業務マニュアルから学習データを自動生成するLLMチューニング技術を開発


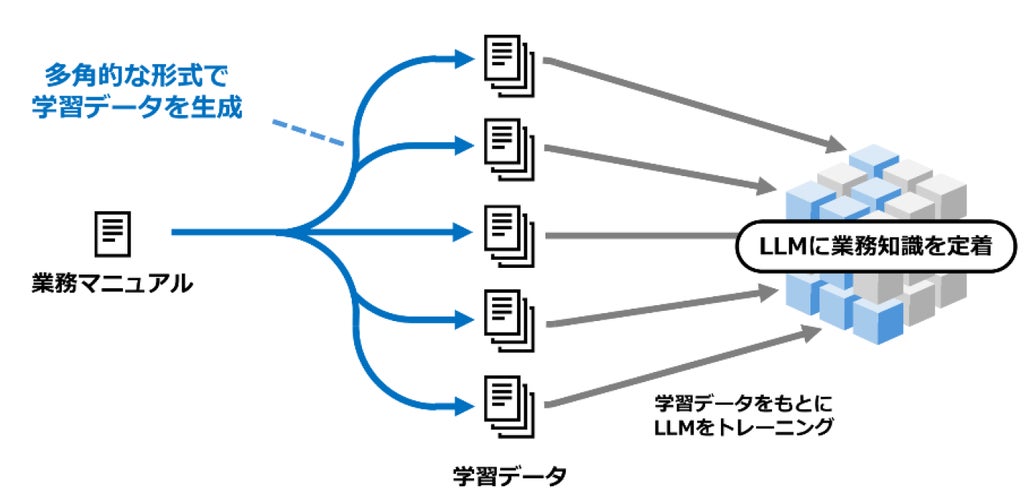
NTT株式会社(本社:東京都千代田区、代表取締役社長:島田 明)は、業務マニュアルの知識を大規模言語モデル(LLM)に定着させるための新たなチューニング技術を開発しました。LLM自身がマニュアルから多様な観点の学習データを自動生成して学ぶことで、膨大な追加データを収集することなく業務知識を高い精度で定着させることが可能になります。この技術は同社が開発するtsuzumiをはじめ、他のLLMにも適用できるとしています。
開発の背景と課題
LLMを特定の用途に合わせて調整するチューニングにおいて、業界特有の知識や業務マニュアルの内容を覚えさせることは難易度が高いとされています。知識を付与する手法として一般的なモデル全体の再学習には、A4用紙テキスト数十ギガバイトを超えるような極めて膨大なデータが必要です。
しかし、実際の業務現場でこれほど大量のマニュアル等を用意することは難しく、インターネット上の類似情報では業務と無関係な情報が混入しやすい課題がありました。そのため、限られた業務資料のみから効率的に知識を定着させる技術が求められていました。
多角的な学びを実現する技術のポイント
今回開発された技術は、LLM自身がマニュアルを学ぶための学習データを多角的に構築し、自らの学びに活用させる手法です。学校の国語の授業で設問や感想などを通じて学びを深める着想に基づき、業務マニュアルから仕様書やFAQといった多様な表現形式のデータを生成します。
生成されたデータを用いて学習を進めることで、従来よりも高い精度でマニュアル内の知識を獲得できるよう設計されています。
実証実験でtsuzumi 2の正答率が83.1%に向上
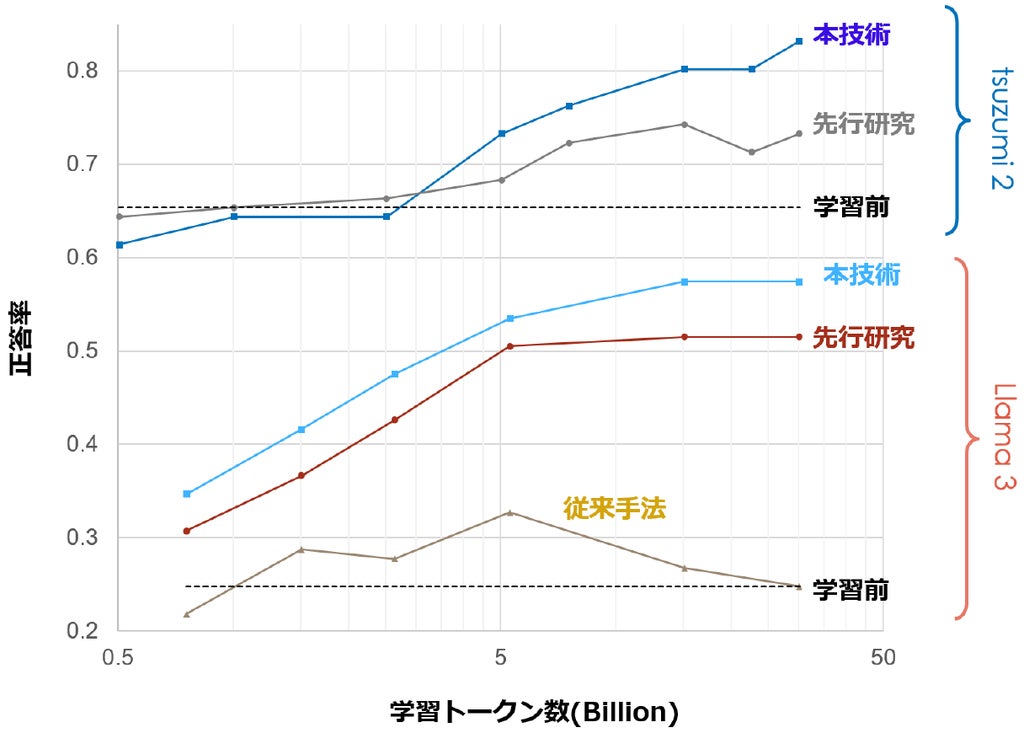
NTTの実業務マニュアルを用いた実験では、マニュアル記載範囲内の問題に対する正答率で知識の定着度を計測しました。実験にはtsuzumi 2とLlama 3(3B)が用いられています。
tsuzumi 2では、学習前の正答率65.3%に対し、先行研究の手法では最大73.3%にとどまりましたが、今回の技術を用いることで83.1%まで向上しました。また、tsuzumi 2より軽量なモデルであるLlama 3(3B)での評価においても、先行研究より優れていることが確認されています。
なお、比較対象とした先行研究は、数学問題・FAQ・表問題・手順書形式への言い換え手法(FinePhrase [Niklaus+, 2026])や、Nemotron-Personas-Japan等の外部データセットからランダムに選んだペルソナに応じて言い換える手法を指します。
今後の展開
本技術は今後、NTTグループ各社に導入される予定です。また、2026年11月18日~25日に開催される「NTT R&D FORUM 2026」(NTT R&Dフォーラム 2026)において本技術の紹介や展示が行われる予定となっています。
本記事はNTT株式会社の発表をもとに作成されています。

ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。