AI Librariumら、社内環境で個人情報を事前検出する軽量手法をCSS2026で発表


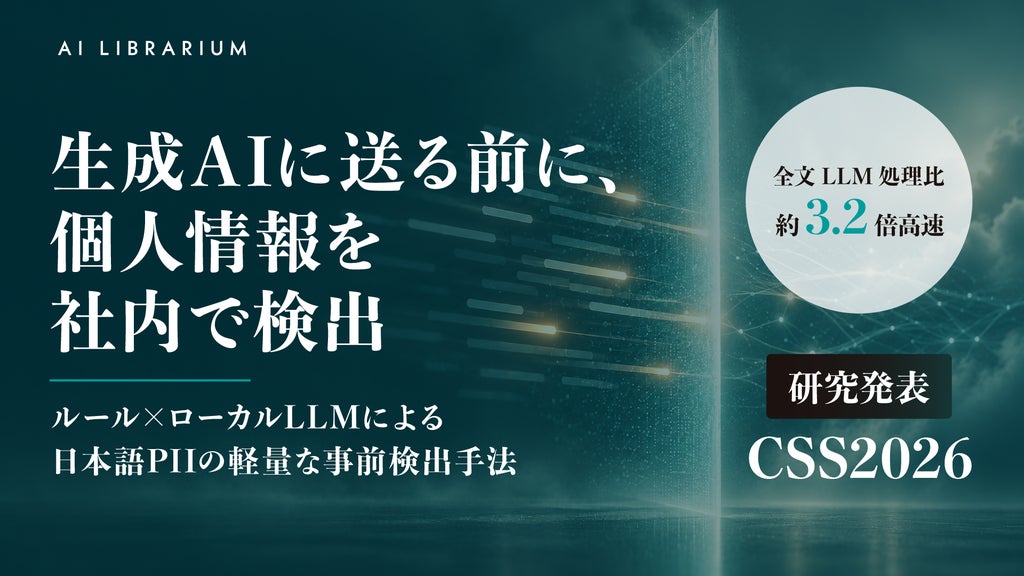
AI Librarium株式会社は2026年10月23日、コンピュータセキュリティシンポジウム2026(CSS2026)において、東北大学の研究者らとの共著論文を発表しました。発表した手法は、社内文書を生成AIなどの外部サービスへ送信する前に、個人識別情報(PII)を社内環境のみで検出・マスキングするものです。日本語500文書を用いた評価では、文書全体をLLMで処理する方式と比べて約3.2倍の速度で動作し、高い精度を記録しました。
本手法は、高速なルール処理とローカルLLMによる文脈理解を組み合わせた構成となっています。
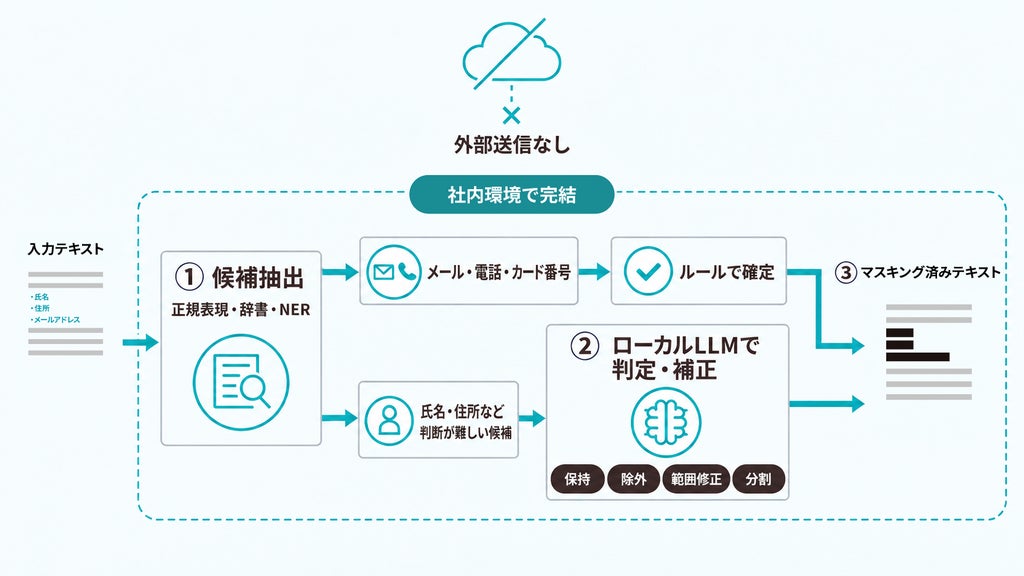
第1段階の候補抽出では、正規表現、都道府県名や一般的な日本人の姓などを収めた固定辞書、日本語の固有表現抽出(GiNZA)を組み合わせて個人情報の候補を洗い出します。形式が明確なメールアドレス、電話番号、クレジットカード番号はこの段階で確定されます。
第2段階では、氏名や住所など判断が難しい候補に限り、ローカル環境で動作するLLM(gpt-oss:20b)が「保持」「除外」「範囲の修正」「分割」の判定や補正を行います。また、「市石@ example.com 」のように@の左側に日本語を含むメールアドレスについても、候補を広めに取ったうえでLLMが文脈から正しい範囲を切り出します。すべての処理は社内のPCやサーバー上で完結し、外部への個人情報送信は発生しません。
評価結果:精度向上と文書全体LLM処理比約3.2倍の速度を両立
公開データセット「OpenPII 1.5M」の日本語文書のうち、開発に使用していない500文書で評価が行われました。
- 提案手法(候補抽出+ローカルLLMによる補正)は、検出精度(Relaxed F1)0.790、平均処理時間11.97秒/文書を記録
- ルール・辞書・NERのみ(LLMなし)の構成は、検出精度0.672、平均処理時間0.026秒/文書
- 文書全体をLLMで処理する方式は、検出精度0.625、平均処理時間38.76秒/文書
- メールアドレスの検出精度は0.558から0.971へ、氏名は0.581から0.745へ向上(LLMなし構成との比較)
- 500文書中74文書(14.8%)はLLMを呼び出さずに処理を完了
- 計測環境は一般的なPC(GPU:NVIDIA GeForce RTX 4060 8GB、メモリ16GB)
なお、住所と電話番号ではLLMなし構成との明確な差は確認されておらず、候補抽出の網羅性向上や実際の業務文書での検証が今後の課題として挙げられています。代表取締役CEOの西川 智章氏は、ルールとLLMの役割を分けて必要な箇所のみを判断させることで、一般的なPC上でも実用的な精度と速度を両立できる知見が得られたとしています。
発表概要と今後の展開
発表された論文の概要は以下の通りです。
- 学会:コンピュータセキュリティシンポジウム2026(CSS2026)
- 主催:一般社団法人情報処理学会 コンピュータセキュリティ研究会
- 発表日:2026年10月23日
- 題目:個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法
- 著者:朝比奈 睦郎(愛媛大学)、原 賢太、塚原 健太郎、三澤 匠、西川 智章(以上、AI Librarium株式会社)、栗林 稔(東北大学 データ駆動科学・AI教育研究センター)
AI Librariumは今後、本研究の成果を企業向けAIガバナンス支援サービス「AIL Governance X」( https://ailibrarium.com/news/pBclbnjf )などの安全対策の取り組みに活かしていく方針です。また、年齢や運転免許証番号などへの検出対象の拡張を進めるとしています。
AI Librarium株式会社の概要
- 会社名:AI Librarium(アイブリウム)株式会社
- 所在地:東京都千代田区丸の内1-6-5 丸の内北口ビルディング9F
- 代表者:代表取締役CEO 西川 智章
- 設立:2025年9月1日
- 事業内容:AIコンサルティング/AIエージェント開発/AI人材育成
- 公式サイト:https://ailibrarium.com/
本記事はAI Librarium株式会社の発表をもとに作成されています。

ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。