GENSHI AI、日本語医療QAデータセットを公開 100万件規模


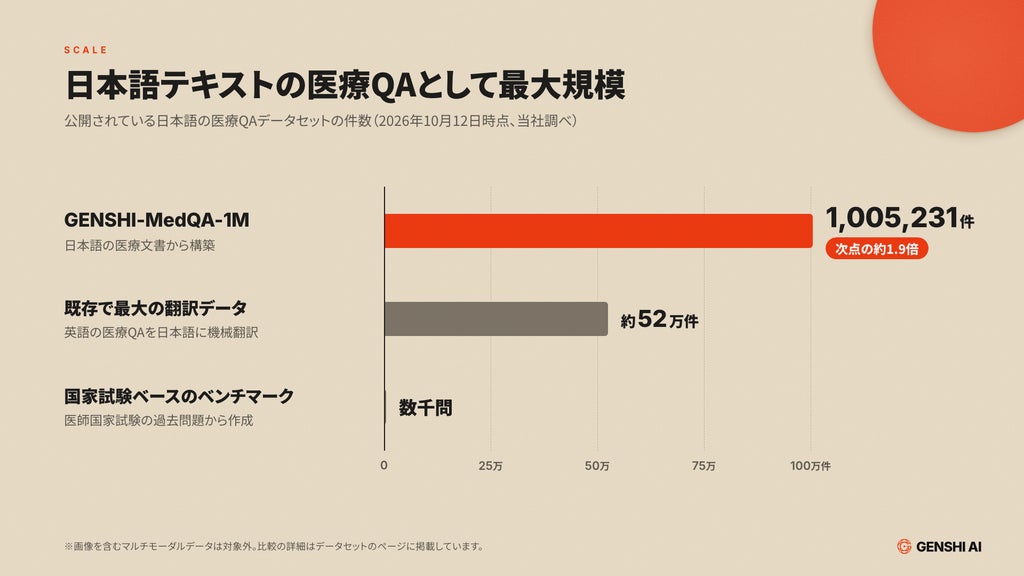
東京都千代田区に本社を置く株式会社GENSHI AI(代表取締役:長嶋 大地)は、日本語の医療QAデータセット「GENSHI-MedQA-1M」を公開しました。独自に収集した日本語の医療文書約18万ページをもとに構築され、1,005,231件の質問と回答で構成されています。公開されている日本語のテキスト医療QAデータセットとしては最大規模となります(2026年10月12日時点、同社調べ)。
日本語医療AIの開発に向けた学習データの構築
医療分野で大規模言語モデル(LLM)を活用するには、日本の診療に即した知識を日本語で学ばせる必要があります。しかし、従来公開されていた日本語の医療QAデータセットは、医師国家試験の過去問題をもとにした数千問規模のベンチマークや、英語のデータセットを機械翻訳したものが中心でした。
翻訳データは最大のものでも約52万件にとどまり(同社調べ)、日本の保険適用や薬の承認状況、国内の診療慣行に関する知識が不足するという課題がありました。臨床で活用する医療AIには、日本語の原文から作成された学習データが求められていたといいます。
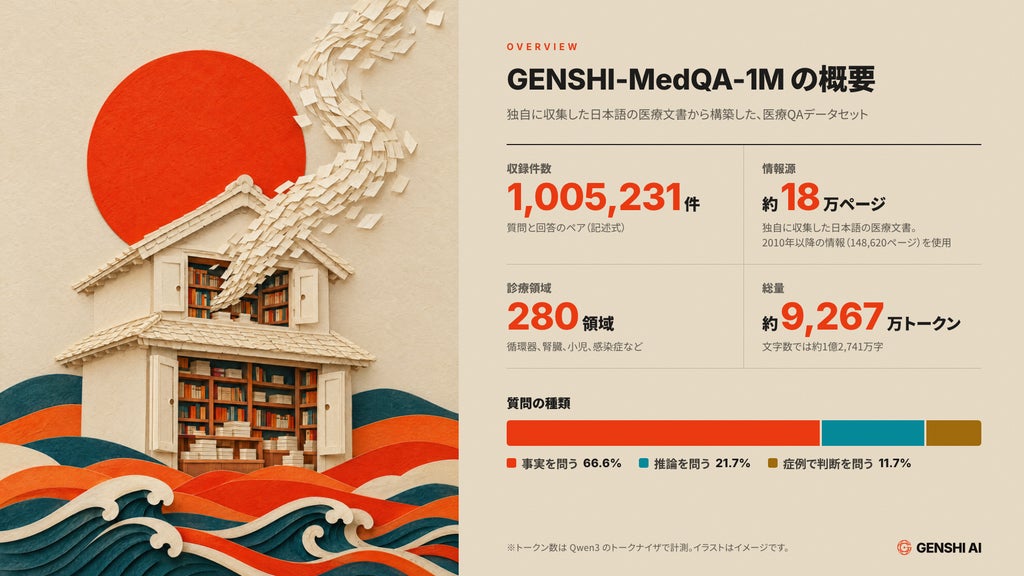
GENSHI-MedQA-1Mは、独自収集した日本語の医療文書をもとに、生成AIを用いて合成された記述式の質問と回答のデータセットです。古い情報を除くため2010年より前の内容は対象外とし、各QAは情報源の記述に基づいて作成されています。
- 収録件数:1,005,231件(約1億2,741万字、約9,267万トークン ※トークン数はQwen3のトークナイザで計測)
- 情報源:独自に収集した日本語の医療文書 179,479ページのうち、2010年以降の情報(148,620ページ)
- 質問の種類:事実を問う質問(66.6%)、推論を問う質問(21.7%)、症例を示して判断を問う質問(11.7%)
- 形式:質問と回答の記述式(1行1組)
- 公開先:https://huggingface.co/datasets/genshiai-daichi/GENSHI-MedQA-1M
データには、臨床的事実だけでなく、病態生理や治療選択の根拠までが日本語の記述式で収録されています。
国内最大規模のデータセット

同データセットは、公開されている日本語のテキスト医療QAデータセットの中で最大規模です(2026年10月12日時点、同社調べ、画像を含むマルチモーダルデータを除く)。比較対象はHugging Faceで公開されているデータセットや論文・プレスリリースで発表されたもので、次に大きい機械翻訳のデータセット(約52万件)の約1.9倍に相当します。
代表取締役の長嶋 大地氏は、日本語の医療AI開発において学習データが課題となっていた背景に触れ、今回の公開が日本の医療AI研究が進むきっかけになることへの期待を寄せています。
利用条件と今後の展望
データセットは、大学・研究機関、医療機関、企業の研究開発部門などでの非商用研究目的に限り無償で提供されます。ライセンスは「CC BY-NC-SA 4.0」で、営利目的のモデル学習を含む商用利用は認められていません。利用にはHugging Faceのページからの申請と、同社による承認が必要です。なお、生成AIで合成されたデータであり人手による全件検証は行われていないため、診断や治療の判断、患者への助言には使用しないよう注意を呼びかけています。
今後は研究者からのフィードバックをもとに修正や見直しを行い改訂を続けるほか、自社の閉域LLM基盤「MedLocal」などの開発にも活用していく方針です。
株式会社GENSHI AIについて
- 会社名:株式会社GENSHI AI(GENSHI AI Inc.)
- 代表者:代表取締役 長嶋 大地
- 所在地:〒101-0024 東京都千代田区神田和泉町1番地6-16 ヤマトビル405
- 設立:2025年11月
- URL:https://genshi.ai
本記事は株式会社GENSHI AIの発表をもとに作成されています。
ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。