「AIは自社サイトを認識できているのか?」umoren.ai、AI学習データの元となるCommon Crawlへの保存状況を確認できる無料ツールを公開


QueueがAI事前学習データチェッカーを公開
CATEGORY: テクノロジー
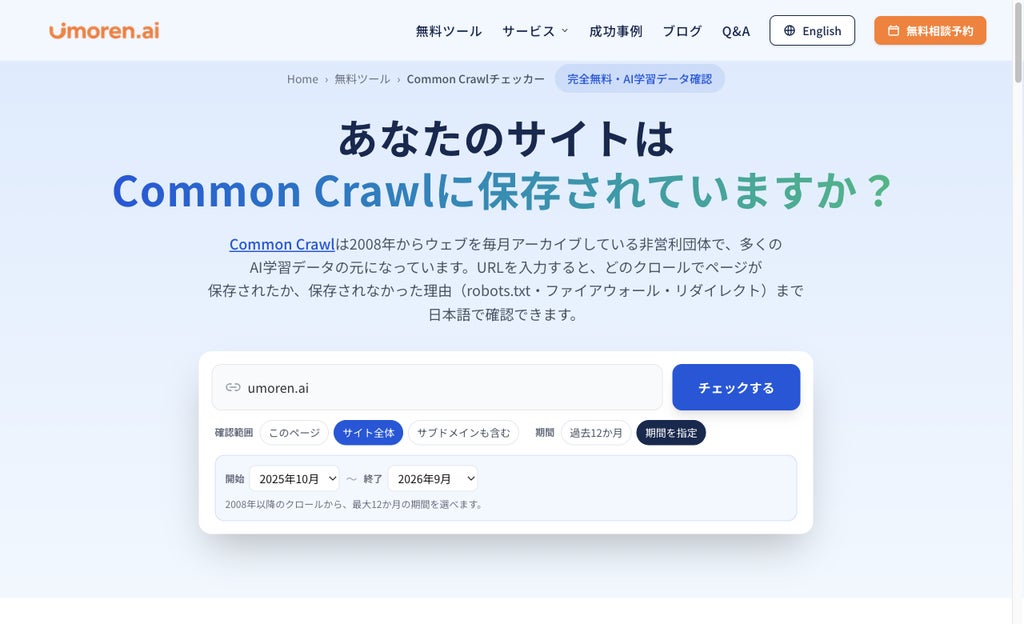
AI検索最適化(LLMO・GEO・AIO)サービス「umoren.ai」を提供するQueue株式会社は、WebサイトがCommon Crawlに保存されているかを確認できる無料ツール「AI事前学習データチェッカー(Common Crawl)」を公開しました。
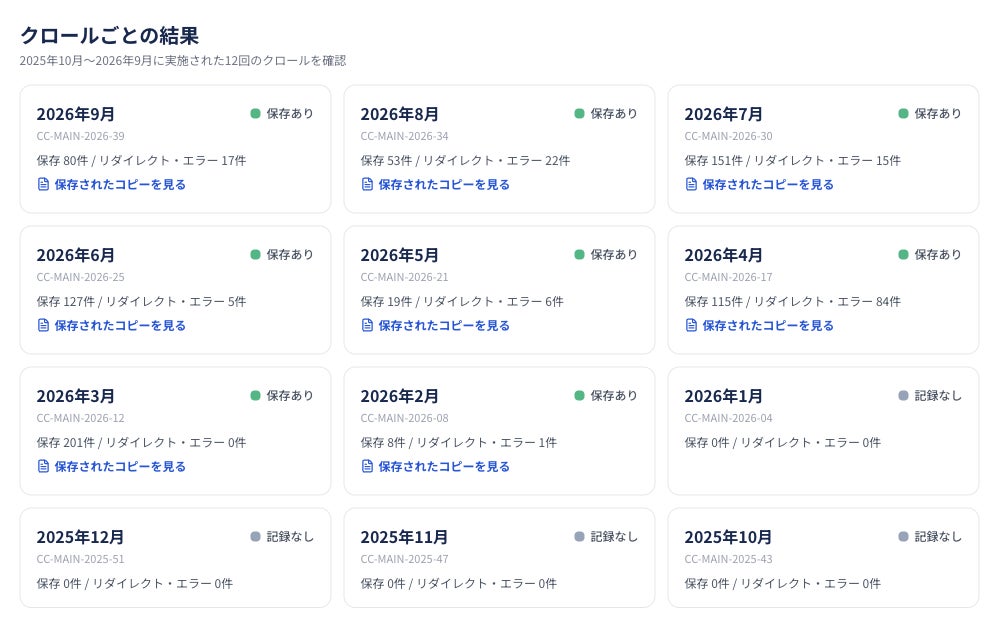
本ツールはURLを入力することでCommon Crawlの公式インデックスを照会し、Webページの保存状況をクロール単位で可視化します。保存の有無に加え、CCBotがアクセスした当時のrobots.txtやセキュリティサービスによるアクセス拒否、保存されたHTMLの内容まで確認でき、企業のAI検索対策における技術的な現状把握を支援します。
開発の背景とAI検索対策における課題
生成AIが商品やサービスの比較・検討手段として利用されるなか、企業にとってAIに自社情報がどのように認識されているかが重要なテーマとなっています。AI検索対策ではコンテンツの品質向上などが注目される一方で、AIの学習データの収集元に自社サイトが含まれているかという前段階の確認が不十分なケースがあります。
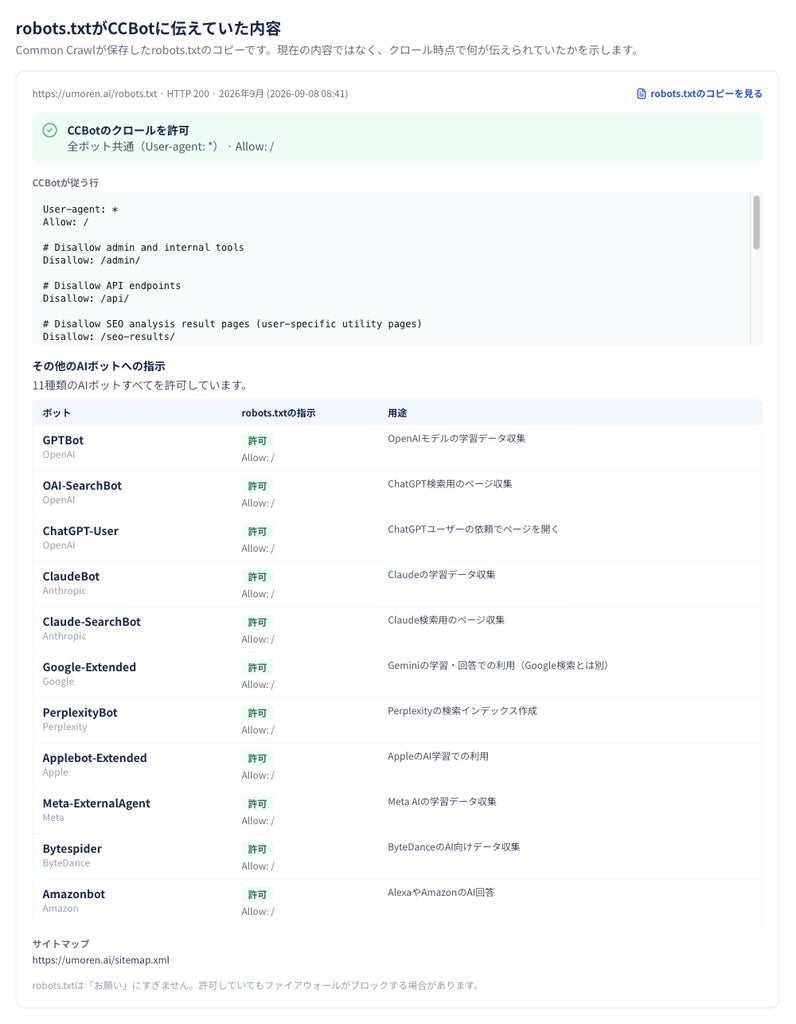
米国の非営利団体Common Crawlが公開するWebアーカイブは大規模言語モデルの代表的なデータソースの一つですが、Webサイトが公開されていてもCCBotの未発見、robots.txtでの拒否、WAFによる遮断、JavaScript依存による本文欠落などの原因で保存されない場合があります。従来はこれらの状況把握に個別の照会や調査が必要だったため、ブラウザ上で確認できる無料ツールとして開発されました。
保存状況やブロック要因を把握する5つの機能
本ツールには、企業の調査を支援する5つの主な機能が備わっています。
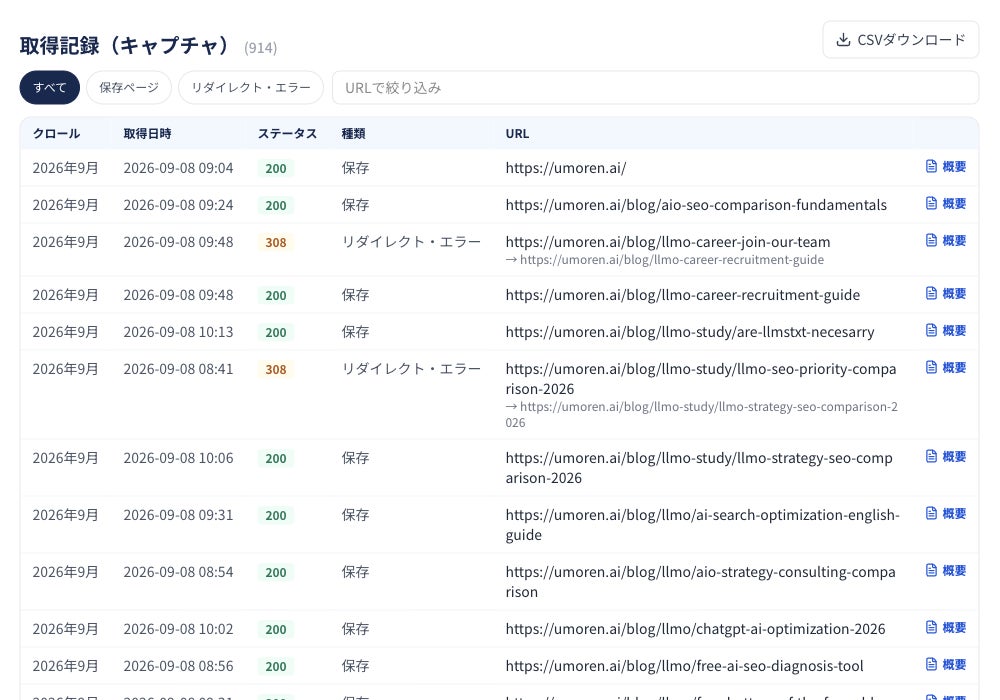
- Common Crawlへの保存状況の可視化:対象URLやドメインを入力し、標準で直近12か月、または2008年以降の任意の期間(最大12か月)を指定してクロールごとの推移やステータスコードを確認できます。
- クロール当時のrobots.txtの確認:現在の設定ではなく、収集当時に保存されたrobots.txtを解析し、CCBotや主要なAI関連ボット(GPTBot、ClaudeBotなど)への指示を一覧表示します。
- クローラーのブロック原因分析:Cloudflare、AWS WAFなどによってアクセスが妨げられた可能性をエラーレスポンス等から分析し、見直すべき設定の候補を日本語で提示します(ブロック元の特定は保存情報に基づく推定です)。
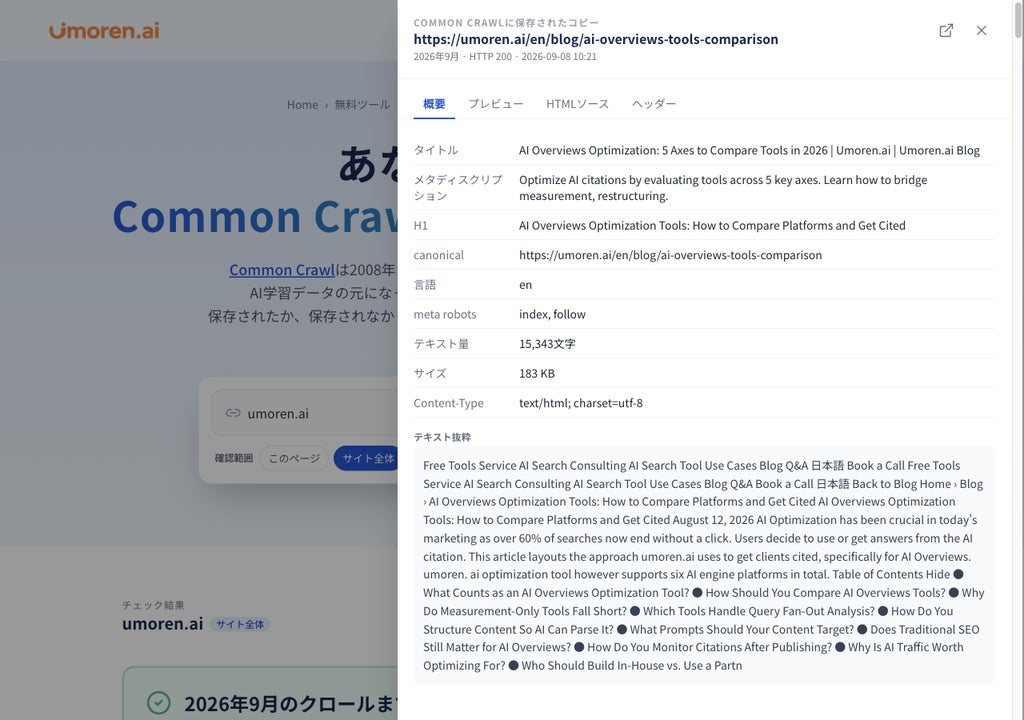
- 保存されたHTMLの確認:JavaScriptを実行しないCCBotが取得したHTMLソースやプレビューなどを表示し、本文テキスト量が不足している場合はJavaScript依存の可能性を伝えます。
- 取得記録の一覧表示とCSVダウンロード:クロール記録を一覧で確認し、絞り込みやCSV形式でのダウンロードが可能です。
本ツールはソフトウェアのインストールが不要で、ブラウザから3つのステップで利用できます。
- URLまたはドメインを入力
- Common Crawlのクロール記録を照合
- 診断結果と原因を確認
単一ページのチェックはアカウント登録なしで開始でき、詳細レポートの閲覧には無料アカウント登録または所定の企業情報の入力が必要な場合があります。
- ツール名:AI事前学習データチェッカー(Common Crawl)
- 提供元:Queue株式会社/umoren.ai
- 公開時期:2026年10月
- 料金:無料
- 対応言語:日本語・英語
- ツールURL:https://umoren.ai/free-tools/common-crawl-checker
Queue株式会社について
東京都中央区銀座に本社を置くQueue株式会社(代表取締役:谷口 太一)は、2024年4月に設立され、LLMO(AI検索最適化)事業やChatGPT広告運用支援を手がけています。同社が提供する「umoren.ai」では、企業やサービスが生成AI上で適切に認識・引用される状態を目指した支援を行っており、今後もデータに基づいた改善のための分析環境を提供していくとしています。
本記事はQueue株式会社の発表をもとに作成しました。
ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。