KandaQuantum、Fuga v2 – Ryuseiを限定リリースへ


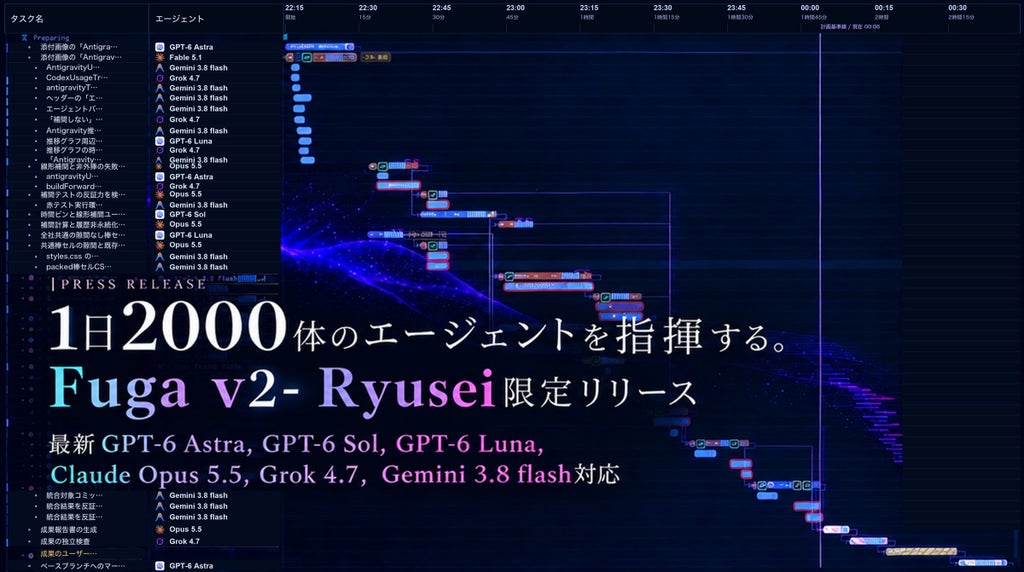
東京都千代田区に本社を置く株式会社KandaQuantumは、AIエージェントの群れ(スウォーム)を計画・実行・統合まで一貫して指揮するオーケストレーター「Fuga」の新版「Fuga v2 – Ryusei」を、2026年9月23日より限定リリースします。
同社は前回発表(Fuga v1、2026年8月29日)以降の約1か月、Fugaの開発そのものをFugaに任せる基盤の再構築を実施しました。その結果、1日あたり2,000体超のエージェント(前回比で倍増)を安定指揮できるようになり、1日あたりの仕事量は約10倍に達したほか、指揮系統の転送効率は77,100%向上、画面への反映は7,700%高速化したとしています。
最新モデルへの対応と難易度に応じた自動割り当て
Fuga v2 – Ryuseiは、OpenAI GPT-6 Astra / GPT-6 Sol / GPT-6 Luna、Anthropic Claude Opus 5.5、xAI Grok 4.7、Google Gemini 3.8 flashに対応しました。Fugaが各タスクの難易度を見積もり、高難度の設計・統合には上位モデルを、定型の実装や調査には高速・低コストのモデルを自動で割り当てることで、1日2,000体規模でもコストが体数に比例して膨らまない仕組みを整えています。
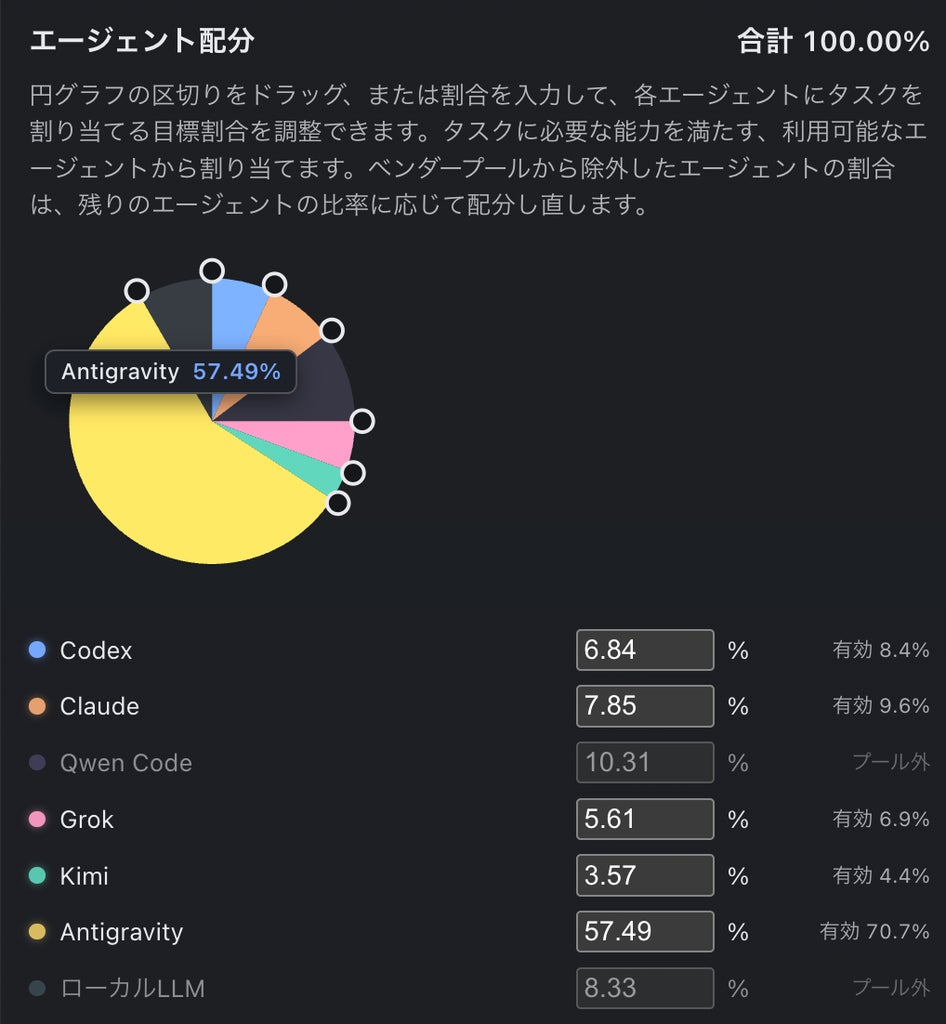
また、ベンダーごとの目標割合を円グラフのドラッグまたは数値で指定できるエージェント配分設定画面を備えています。これにより、計画から並列実装、統合、成果報告書の生成、独立検査、ベースブランチへのマージまでを一連で進める開発依頼において、複数社のモデルによる役割分担が可能となっています。
質と量の両立による仕事量約10倍の達成
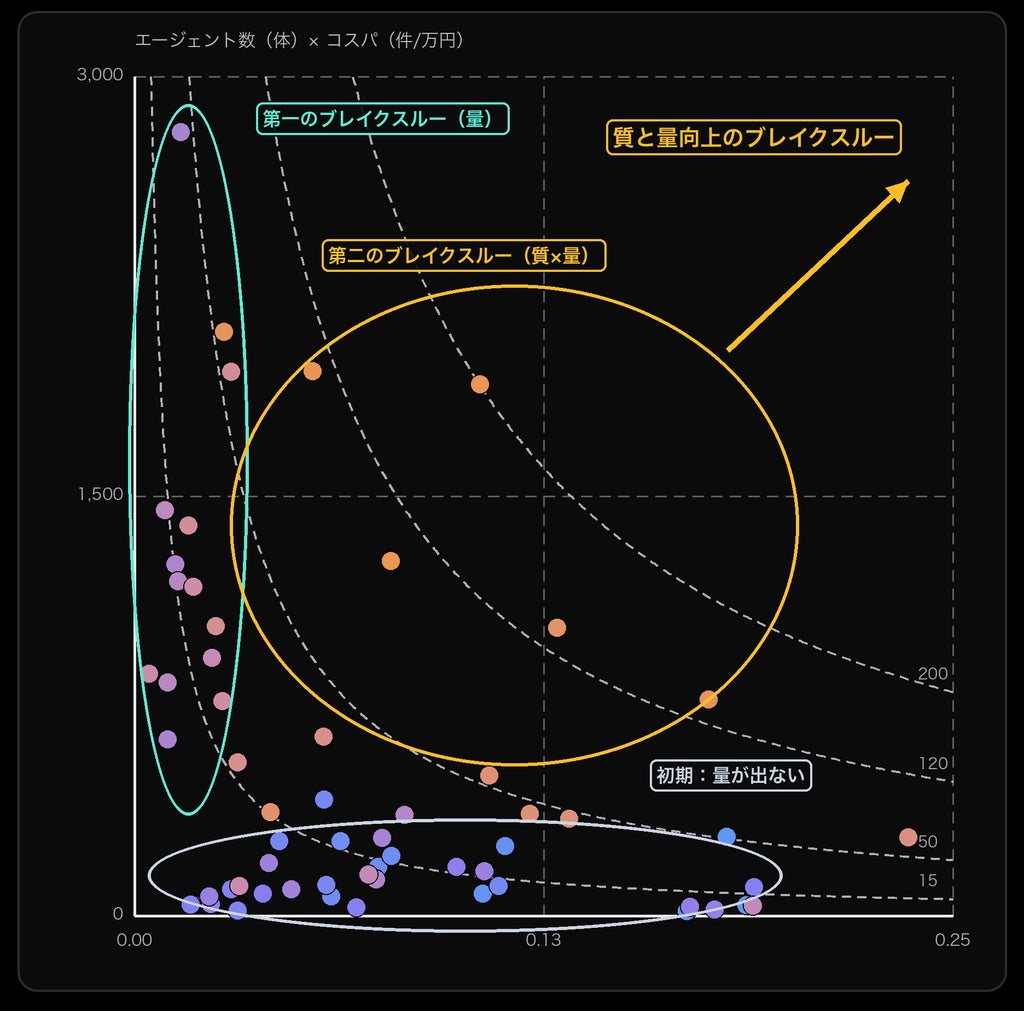
前回のリリース(Fuga v1)では1,285体のスウォームの安定稼働が示されましたが、体数(量)を増やすと1体あたりの成果が落ち、成果の質(コストパフォーマンス)を上げようとすると体数を絞らざるを得ないトレードオフが課題となっていました。
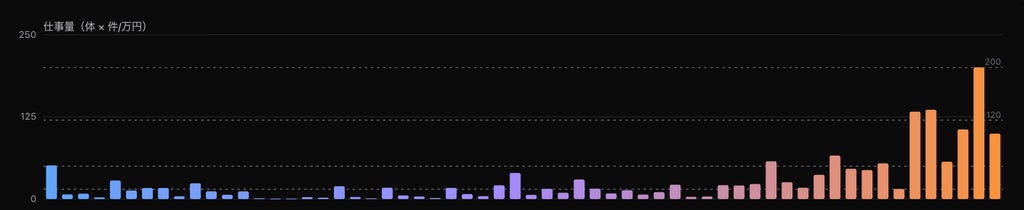
同社は動員数を「量」、コストあたりの完了タスク数を「質」、その積を「仕事量」とする指標を構築し、2次元グラフで状態を可視化しました。Fuga v2 – Ryuseiでは量を保ったまま質を引き上げるブレイクスルーを実現し、1日あたりの仕事量を約10倍に増大させました。Fugaが自身の改善のために稼働させたAIの作業量を人件費に換算すると、7月の約6,367万円から、8月は約1.7億円、9月は見込みで約4.1億円に達するとしています。
再帰的自己改善(RSI)による自律的なボトルネック解消
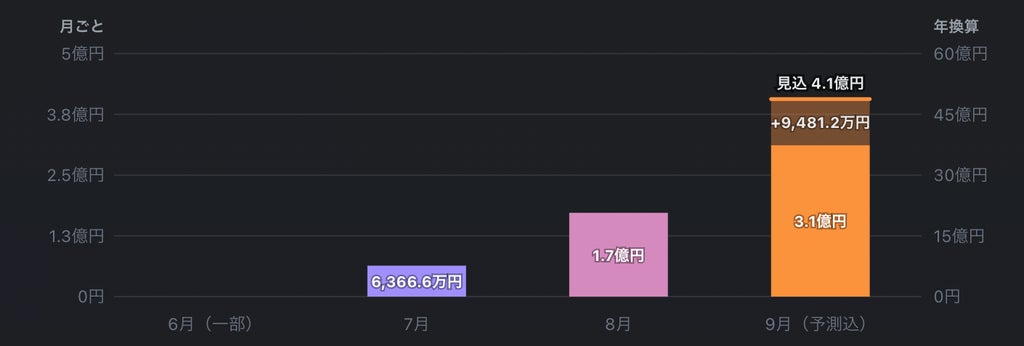
Fugaは稼働ログからボトルネックを検証し、To-Doタスクとして整理したうえで、タスクごとに20〜100体のエージェント組織を呼び出して調査・実装・テスト・統合を進めました。当初は人が判断していた範囲を段階的にオーケストレーターへ移行し、ほぼ完全に自律した再帰的自己改善(RSI:Recursive Self-Improvement)ループを1か月回し続けた結果、社内実測として以下の改善が実装されました。
処理速度
- 転送効率:77,100%向上(計画AI出力の重複送信を根絶、転送量99.9%削減)
- 画面反映の遅延:最大778秒 → 秒単位(7,700%高速化)
- 承認から着地まで:5分の停滞 → 15秒(1,900%高速化)。直近71件中57件(80%)は承認1回でベースブランチへの統合まで自動で完走
- 計画AIの応答:中央値129秒 → 51秒(153%高速化)
- 配信の滞留:21,895件 → 定常0件、通信の確認タイムアウト:39件 → 0件
- CI(事前検査):22分21秒 → 5分30秒(75%短縮)
耐障害性
- 画面プロセスのクラッシュ・30秒の無応答・通信断のいずれからも自動復旧し、走行中のタスクは維持
- 通信タイムアウトの回復ループ:5.7万回 → 0回
- アプリを終了(Command+Q)しても、中断したエージェントは次回起動時に同じ会話から作業を再開
- ワーカー起動の失敗率:10.1% → 1.9%(81%削減)
メモリ・ディスク
- 状態ファイル:159MB → 54MB(66%削減)、1セッションあたりのrun記録:154KB → 17.5KB(89%削減)
- 高負荷時のメモリ増分:44〜91%削減
提供形態と算出指標の前提
Fuga v2 – Ryuseiは、KAMUI SaaS プラットフォーム上でクローズド・リリース(限定提供)として提供されます。
なお、同社が提示する指標の定義および前提条件は以下の通りです。
- 仕事量・コストパフォーマンスの定義:量=その日にFugaが自身の改善のために駆動したエージェント数(体)。質=コストパフォーマンス(件/万円)=その日に完了したタスク数 ÷ その日の稼働コスト(万円)。仕事量=量(体)× 質(件/万円)。集計期間は2026年7月19日〜9月22日(稼働60日)。
- 稼働コストの算出:人件費換算(概算)で、AI実稼働時間×25万円/hとして算出。人月単価160万円(月160時間稼働として1時間あたり1万円)のエンジニアに対し、AIの1時間の稼働が約25倍の実装速度に相当すると仮定した暫定係数。25倍はFuga v1で示した「1日の稼働で約8〜15人月(約1,280〜2,400人時)相当の開発」(稼働1時間あたり約53〜100人時相当)を保守的に見積もった数値。
- 数値の性質:人件費換算の単価(25万円/h)、コストパフォーマンス、仕事量は確定値ではなく暫定値。特に質の評価は完了タスクを一律1件と数える評価であり、今後はタスクの種類や難易度に応じた加重評価や実測に基づく精緻化を進めるとしている。
- エージェントの定義:独立した実行単位として起動したLLMインスタンス1つを1体と定義(※2)。
本記事は株式会社KandaQuantumの発表をもとに作成。
ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。