NABLAS、日本語ファクトチェック特化LLMのNABLA-FCを開発・公開


AI総合研究所として活動するNABLAS株式会社は、日本語のファクトチェックに特化したLLM「NABLA-FC」を開発し、Hugging Faceにて公開しました。この開発は、経済産業省と国立研究開発法人 新エネルギー・産業技術総合開発機構(NEDO)が実施する国内生成AI開発の推進プロジェクト「GENIAC」の第3期において採択された「Factcheck RM とエージェントの開発研究」に関する取り組みとして行われたものです。同社は本モデルをベースにしたファクトチェックエージェントにより、判定の裏付けとなった一次情報やWeb上の出典明示を自律的に行い、情報検証コストの削減と安全かつ高精度なファクトチェック基盤の提供を目指しています。
判定根拠と出典を自動明示する学習構造
「NABLA-FC」は、入力された文章を最小単位の主張に分解し、自律的にWeb検索やページ訪問を行って最新情報を収集・照合します。真・偽・根拠不十分などの判定結果に加え、判断に至った論理プロセスや参照した具体的なWebページのURL、証拠要約をレポートとして出力する仕組みです。
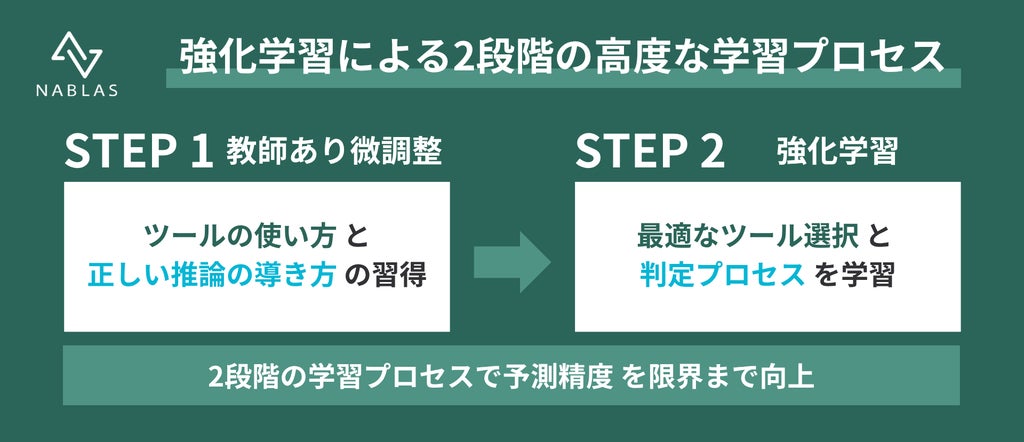
モデルの学習には2段階のアプローチが採用されています。「教師ありファインチューニング(SFT)」ではRejective Fine-Tuning (RFT) によるデータ選別を用い、正しい論理展開と適切なツール利用のデータのみを厳選して適用しました。続く「強化学習(RL)」では、Group Relative Policy Optimization(GRPO)を用い、モデルの予測スコアが正解と一致した場合に「+1」、そうでない場合に「-1」を与えるルールベースの報酬設計に基づき、検索ツールの選択能力と真偽判定の精度の向上を図っています。
単一GPUで動作する8Bモデルと検証精度
ベースモデルには8B(80億パラメータ)規模のモデル構造が採用されており、GPU 1枚の手元環境(オンプレミス・ローカル環境)でも動作します。これにより、報道前の未公開記事や機密性の高い社内資料の全文を外部クラウドAIサービスに送信することなく、安全にファクトチェックを行えるとしています。
ネット上の真偽不明情報に関する日本語ベンチマークデータセット「JSocialFact(33件)」を用いた精度評価では、以下の数値を記録しました。
- NABLA-FC(RL適用モデル):97%(32/33件)
- NABLA-FC(SFT段階モデル):94%(31/33件)
- Gemini 3.1 Flash-Lite Preview:88%(29/33件)
- GPT-4o-mini:73%(24/33件)
公開先URL:https://huggingface.co/nablasinc/NABLA-FC
実証実験での作業時間削減と今後の想定用途
現場の専門家と連携した報道機関向けのユースケース実証実験では、拡散するSNS投稿や海外ニュースの一次調査・裏どり作業において、確認作業の時間が約45〜60分から約10〜15分へと約75%削減(処理効率を約4倍に)されたとしています。
このほか、災害発生時や選挙期間中のSNS上の噂・偽画像の確認を行う官公庁・自治体や、自社製品・役員・企業ブランドに関するレピュテーションリスク情報の早期検知・検証を行う企業などでの活用が見込まれています。同社は今後もプロジェクト成果であるモデルおよび関連技術をHugging Faceにて順次公開していく方針です。
NABLAS株式会社の概要
- 社名:NABLAS株式会社
- 代表者:代表取締役 所長 中山 浩太郎
- 本社:東京都文京区本郷6-17-9 本郷綱ビル1F
- 設立:2017年3月
- 事業内容:AI人材育成事業・コンサルティング・研究開発
- URL:https://nablas.com
本記事はNABLAS株式会社の発表をもとに作成されています。
ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。