イレブンラボ、医療向け音声認識モデルScribe v2 Medicalを提供開始


イレブンラボジャパン合同会社は、医療分野向けの音声認識モデル「Scribe v2 Medical」について、バッチ処理のSpeech to Text APIによる正式提供を開始しました。2026年5月から先行提供されていたモデルで、薬剤名や解剖、病理、臨床の口述筆記など診療に関わる音声の認識精度を高めています。同モデルは医療AI企業が自社の記録作成サービスや診療支援製品を構築するための土台として活用される想定です。
臨床現場の音声を対象とした「Scribe v2 Medical」の概要
Scribe v2 Medicalは、汎用の音声認識モデル「Scribe v2」を医療向けに追加学習したモデルです。診療中の会話記録や医療スクライブ(診療記録の作成補助)、口述筆記、問診、医療機関間の連携に伴う通話など、臨床現場で発生する音声を対象としています。
同モデルは会話や口述をテキストに変換する役割を持ち、カルテなどの文書生成や診断・治療方針の判断を行うものではありません。出力データは医療従事者などの権限を持つ利用者が確認・修正して使用することが想定されています。なお、Scribe v2をベースとしているため一般的な音声に対する認識精度も維持されており、精度の検証は英語、フランス語、ドイツ語で実施されています。
公開ベンチマークと第三者評価による認識精度
認識精度の検証は、公開ベンチマークと医療AI企業Nablaによる第三者評価で行われています。
臨床音声3,619件を用いた公開医療ベンチマーク「Eka Medical ASR」テストセットにおいて、単語誤り率は7.0%を記録しました。ベースとなったScribe v2の8.6%から1.6ポイント低下し、前世代の「Scribe v1」の18.6%と比較して半分以下となっています。
また、AIが実際には話されていない言葉を書き足すハルシネーションの発生率について、Nablaによる評価では医療用語での発生割合が0.4%となり、Scribe v2の0.7%から減少しました。実在しない薬剤名を作り出すなどの誤りはなく、残る誤りも実在する単語の綴りの間違いでした。
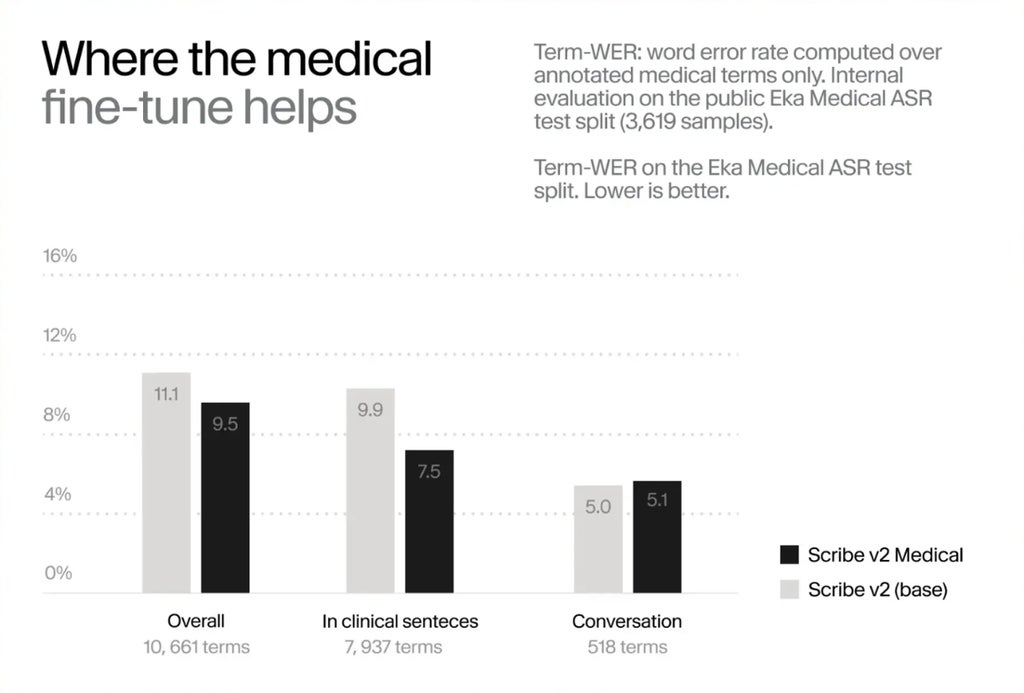
一般的な会話音声のテスト(CommonVoice、6,000件)では単語誤り率がScribe v2と同じ5.3%となり、精度の低下は見られませんでした。医師の口述筆記を対象としたテスト(Corti MedDictate)の英語・フランス語・ドイツ語評価では、Scribe v2と比べて単語誤り率が相対的に約36%低下しています。
医療データに対応するセキュリティ機能
エンタープライズ契約の利用者は、BAA(Business Associate Agreement)を締結し、Zero Retention Mode(ZRM)を有効化することでHIPAAに対応した運用が可能です。
ZRMはAPI経由で設定でき、有効化したリクエストの処理完了直後に入力音声と出力テキストが削除されます。システムが受け取った文字起こしデータの保存および管理は利用者側で実施する仕組みとなっています。
イレブンラボ(米国ニューヨーク州、CEO:Mati Staniszewski)は2022年に設立されたAI研究・プロダクト企業です。音声合成、音声認識、会話型AIなどを提供しています。
- 企業評価額: 110億米ドル
- 提供サービス: ElevenAgents、ElevenCreative、ElevenAPI
- 日本語サイト: https://elevenlabs.io/ja
- 日本語版LinkedIn: https://www.linkedin.com/company/elevenlabs-japan/
- 日本語版X(旧Twitter): @ElevenlabsJapan
- 公式note: https://note.com/elevenlabs_japan
本記事はイレブンラボジャパン合同会社の発表をもとに作成しました。

ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。