ワタップやハイレゾなど、LLMとGPU運用の可視化を解説するセミナーを開催へ


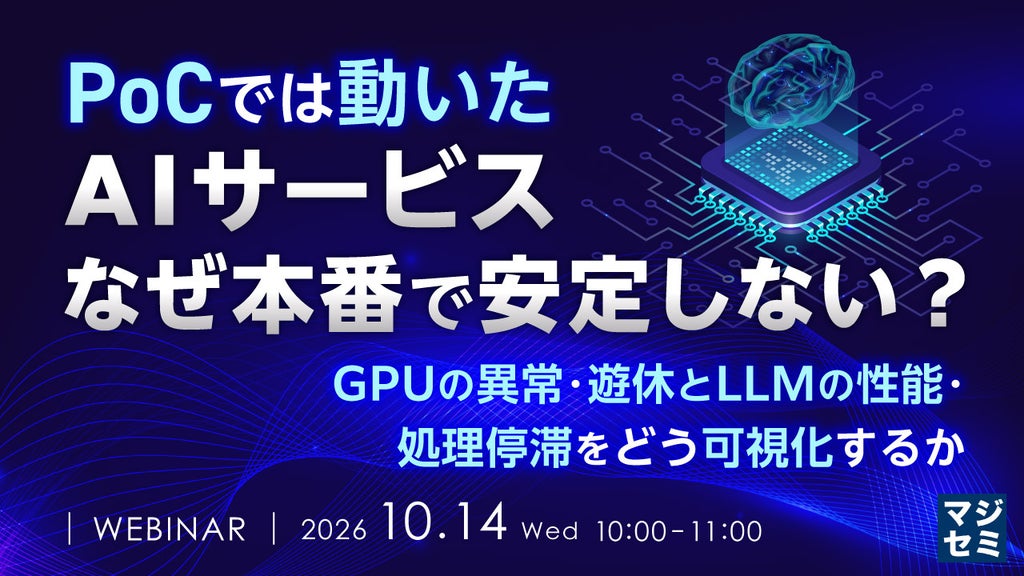
ワタップ・ジャパン株式会社、株式会社ハイレゾ、インフラレッド合同会社は、LLMとGPUの横断的な可視化に関するオンラインセミナーを開催します。企画・運営にはマジセミ株式会社が協力します。
本セミナーでは、InfraRed社がAIサービスを開発・検証・本番運用する中で直面した課題や、その改善事例をもとに、計算資源とLLM処理の双方からAIサービスの運用状態を把握する方法が紹介されます。
AI基盤におけるPoCから本番運用への移行課題
生成AIやLLMを活用したサービスにおいて、PoC段階ではモデルの動作確認が中心となりますが、本番運用や商用化へ進むにつれて運用面の課題が生じます。具体的には、大量データを期限内に処理できるか、GPUやCPU、メモリなどのリソースを安定して利用できるか、障害発生時に原因を迅速に特定できるかといった点が挙げられます。
ローカルLLMやGPU基盤においては、モデル単体の性能に加え、処理量や納期、複数ジョブの並行実行を含めた基盤全体の設計と管理が求められます。
GPU稼働状況とLLM処理性能の可視化
GPU使用率が高い状態であっても、AIサービスの処理が正しく進行しているとは限らないケースがあります。InfraRed社の実運用では、高いGPU稼働率の裏で重複処理が発生した事例や、コンテナ、ログ、プロセス上は正常に見えても実際には処理が進んでいなかった事例が確認されています。
ローカルLLM環境では、パイプライン上の異常や停滞箇所の可視化が必要であり、GPUの稼働状況とLLMの処理性能や進捗を個別に監視するだけでは、本番運用上の問題を捉えきれない場合があるとされています。
セミナーでは、GPUSOROBANによる大規模GPU環境の活用に加え、WhaTap GPU Monitoringを用いたGPUの利用状況、プロセス、異常の可視化手法が取り上げられます。
あわせて、WhaTap LLM Observabilityを活用し、モデルやエージェント単位の処理状況、ボトルネック箇所、ハルシネーション、プロンプトを確認することで、GPUという計算資源とその上で動作するLLM処理の双方からAIサービスの運用状態を把握する方法が解説されます。
開催体制
本セミナーの主催および運営体制は以下の通りです。
- 主催・共催: ワタップ・ジャパン株式会社、株式会社ハイレゾ、インフラレッド合同会社
- 協力: マジセミ株式会社
本記事はマジセミ株式会社の発表をもとに作成しています。
ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。