ElevenLabsが新モデルEleven Realtimeを提供開始


米国のElevenLabsは、音声エージェント向けの新たな音声対音声(Speech to Speech)モデルであるEleven Realtimeを発表しました。会話の速さと自然さに最適化したEleven Realtime v1 Miniと、複雑なタスクに最適化したEleven Realtime v1 Maxの2モデルを揃えています。
音声・チャットエージェントプラットフォームのElevenAgentsおよびRealtime APIを通じて提供されます。
個別の構成要素を統合した音声モデル
従来の自然に話す音声エージェントの構築では、音声認識や発話区間の検出、話者交代(ターンテイキング)、大規模言語モデル(LLM)、音声合成などの各要素を個別に選んで調整する必要がありました。Eleven Realtimeは、これらの構成要素を1つのシステムとして調整しており、ユーザーはモデルを選ぶだけでエージェントを構築できます。
両モデルとも日本語・韓国語を含む90以上の言語に対応し、17,000以上のボイスライブラリから声を選択可能です。自然な話者交代や割り込みへの対応、ツール呼び出しをサポートするほか、各段階でテキストを介して処理するため、ガードレールの適用や会話内容の追跡(トレーサビリティ)が行えます。用途に応じた2つのモデルの特徴は以下の通りです。
- Eleven Realtime v1 Mini:速く自然な会話に最適化されており、AIアシスタントや教育向けチューター、ゲーム・エンターテインメントのインタラクティブなキャラクターなどに適しています。
- Eleven Realtime v1 Max:複雑なタスクに最適化されており、手順に沿った対応や情報検索が必要なカスタマーサポート、見込み客の選別(リードクオリフィケーション)、複数ステップの業務などに適しています。
第三者機関のベンチマーク評価
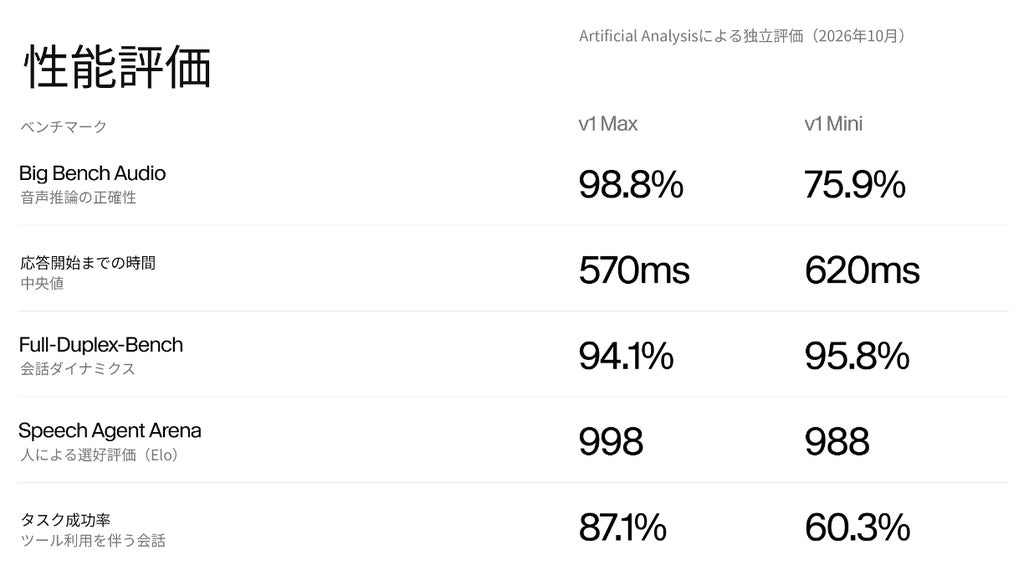
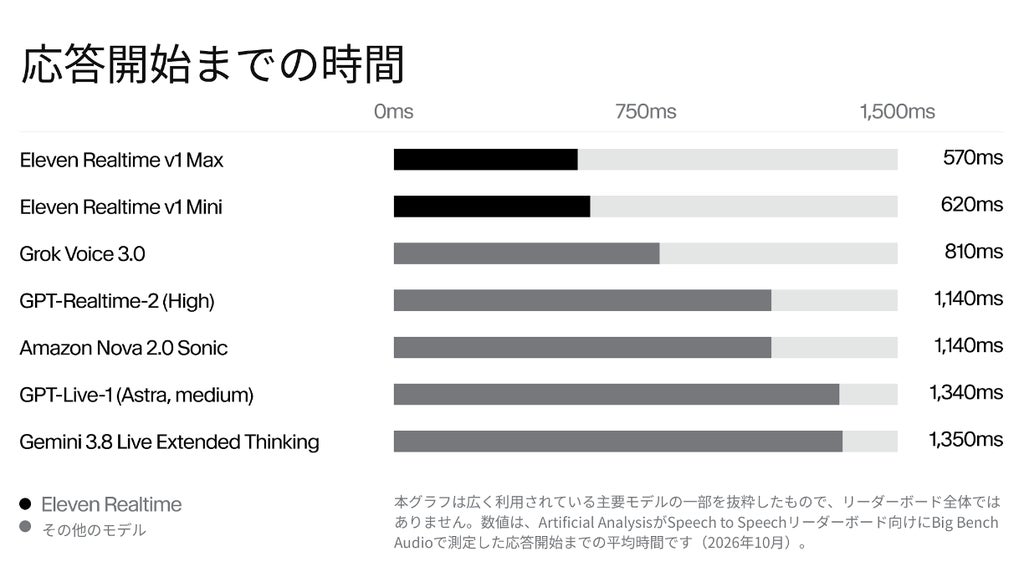
第三者評価機関のArtificial Analysisによる評価(2026年10月時点)において、Eleven Realtime v1 Maxは音声による推論力を測るBig Bench Audioで98.8%の正答率を記録し、質問を聞き終えてから話し始めるまでの時間は0.57秒でした。同社のリーダーボードでも、正答率と応答速度の両面で高い評価を得ています。
また、会話中の間(ま)、話者交代、割り込み、相づちへの対応を測るFull-Duplex-Benchでは、v1 Miniが95.8%、v1 Maxが94.1%のスコアを記録しました。
提供方法とAPI連携
ElevenAgentsでは、エージェント作成画面や既存エージェントのモデル選択欄からEleven Realtimeを選ぶことで利用できます。電話やWebサイト、WhatsApp、コンタクトセンタープラットフォームなどのチャネル展開をはじめ、ワークフローやナレッジベース、モニタリングなどの既存機能をそのまま活用可能です。
Realtime APIはWebSocketで接続し、OpenAIのRealtime APIと互換性を持っています。既存のコードの接続先とモデル名を変更することで導入できますが、提供開始時点ではWebRTCには対応していません。料金体系は、ElevenAgentsでは通常の分単位の料金に言語モデルのトークン料金を加算した額、Realtime APIでは接続中の音声の分単位の料金にトークン料金を加算した額となります。
日本市場における課題と展開
リクルートワークス研究所の試算によると日本では2040年に約1,100万人の働き手が不足するとされており、顧客対応の現場におけるサービス品質の維持が課題となっています。営業時間や手続きの案内、予約受付といった定型的な問い合わせを音声エージェントが担うことで、担当者が丁寧な相談や判断を要する対応に注力できる環境づくりを目指します。
ElevenLabsは、米国ニューヨーク州に本社を置き、CEOをMati Staniszewskiが務めています。2022年に設立され、現在の企業評価額は220億米ドルを超え、プラットフォームはFortune 500企業の80%以上を含む数千社に利用されています。
本記事はElevenLabsの発表をもとに作成されています。

ビジネスパーソンの課題解決と納得感にこだわるDellows News編集部。キャリア論からAI、健康法まで幅広い分野に対応し、複雑なテーマでも平易な言葉で丁寧に解説。読者が「明日から使える」知識やヒントを得られるよう、具体的な事例・データ・専門家の見解を交えて執筆。情報を整理し、納得感ある記事づくりを心がけています。